"用了这么久Claude Code,你的效率真的变了吗?"老金问过不少开发者,答案大多是"比以前快了一点,但没有传说中那么神"——他的诊断是:问题不在工具,在用法。这篇用一个跑了一年多的真实项目TinyPA(PDA记事应用:记一句话,LLM自动拆成todo/note/mood,每晚复盘早间推报)做样本,给出三件让效率真正变好的事。
一、建立行为规范:一份CLAUDE.md值15,000颗星
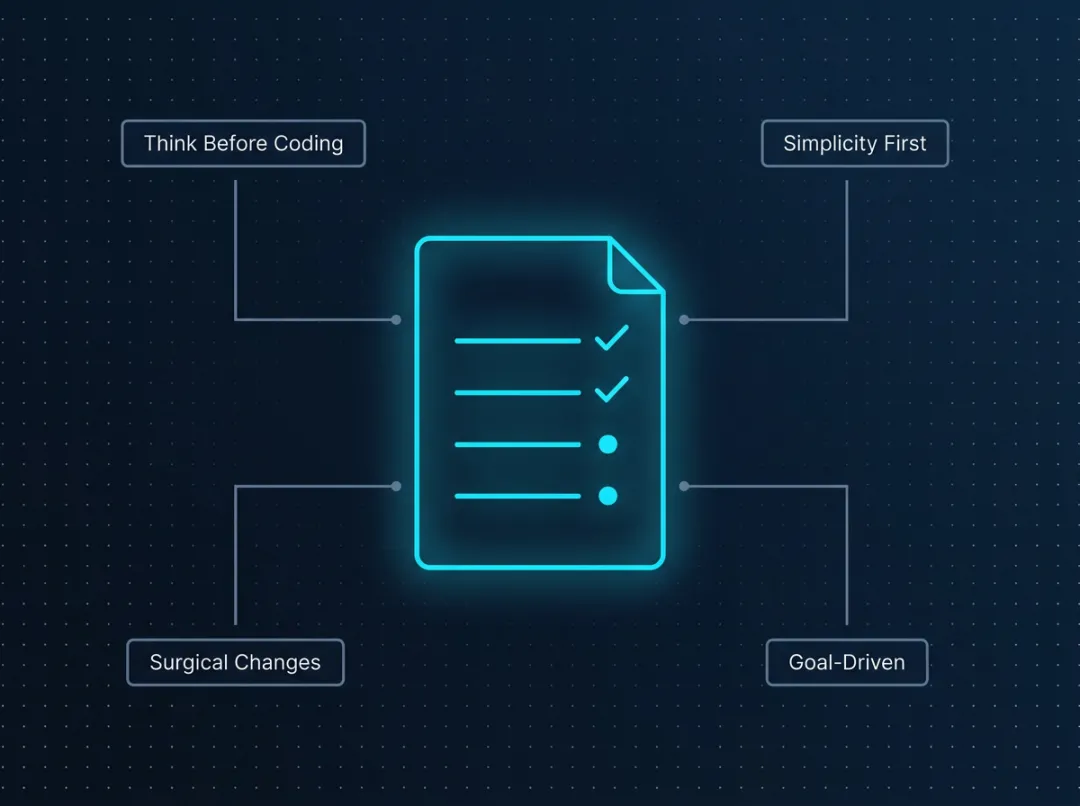
多数人的用法是每次新对话重新解释项目背景——这等于没给Claude任何持久记忆。Andrej Karpathy总结过LLM写代码最常犯的错误(过度设计/忽略现有模式/加不必要依赖/乱改未要求的代码),有人把这些整理成CLAUDE.md模板放进项目根目录,一周内在GitHub拿了15,000星。四条核心原则:Think Before Coding(阻止错误假设)、Simplicity First(阻止过度设计)、Surgical Changes(外科手术式改动)、Goal-Driven Execution(测试先行)。实测数据:没有CLAUDE.md时约40%的情况违反规范,用了之后降到约3%,设置时间5分钟。老金的体感案例:把默认模型从Llama切到Gemini,没有规范时这种改动会被"顺手"扩成一周的重构(再封一层接口、拆包、做枚举);加了Surgical Changes后同样的任务只改三处默认字符串加重命名,两个commit干净收工。
二、定义角色:别把Claude Code用成搜索引擎
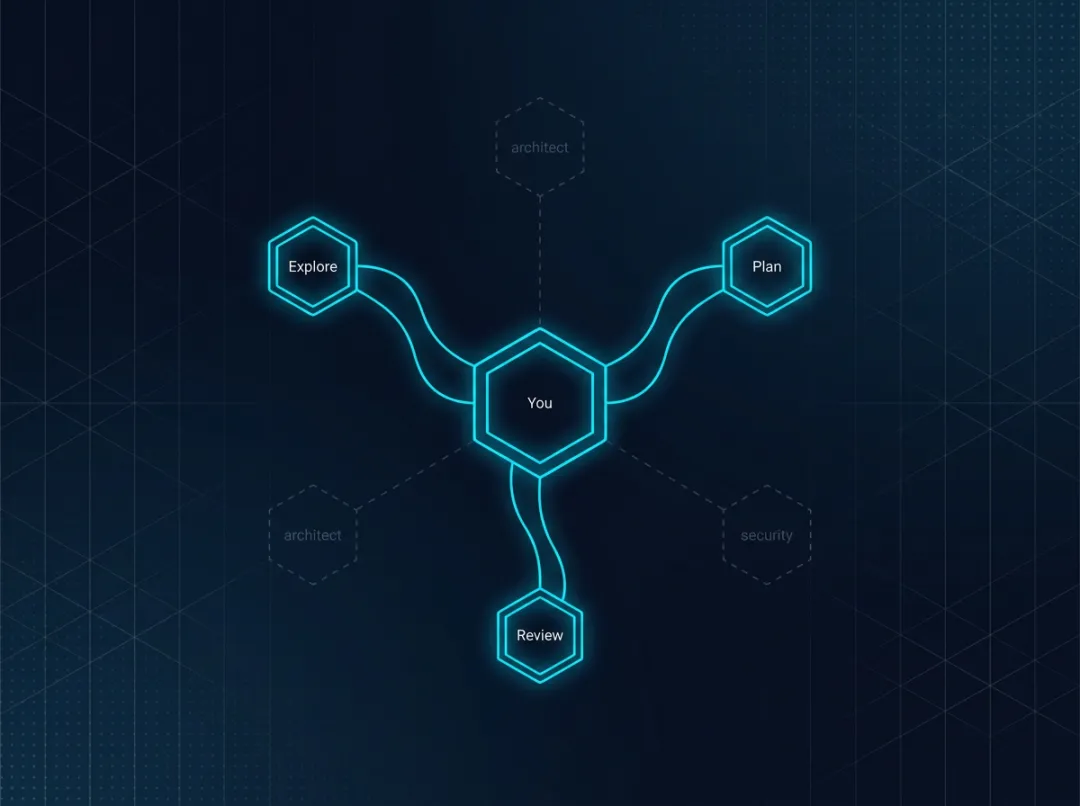
打开对话框→描述需求→等输出→复制粘贴→发现不对再描述,这是高级搜索引擎的用法。正确姿势是给角色给工具让它在系统里跑:everything-claude-code仓库(153,000+星)提供planner/architect/tdd-guide/code-reviewer等现成角色配置。重要提醒:不要一次性全装——27个Agent+64个Skill同时加载,上下文直接撑爆。老金实际只用三个:Explore(只读搜索,迁移前一次性列出所有相关代码位置,不占主对话上下文)、Plan(动手前出架构方案,他自己改两处再让主线程实现,一次跑完无返工)、code-review(commit前过一道,auth和密钥相关代码让独立reviewer看比自查靠谱)。
三、Token陷阱:版本差异2万个Token
用Claude Max的人可能遇到过:CLAUDE.md写得清楚,Claude却突然开始忽略规则。有人用HTTP代理拦截请求发现了原因:v2.1.98版169,514字节请求计费49,726 tokens,v2.1.100版168,536字节(更少)却计费69,922 tokens——字节数更少,Token多了2万,这2万Token占的是真实上下文窗口,直接把CLAUDE.md挤出有效记忆。临时方案:`npx claude-code@2.1.98`锁版本。小项目尤其明显——上下文窗口不大时,几千字差额就够让规范变空气。
四、真正的自动化:人负责判断,系统负责执行
TinyPA的自动化分两层:产品本身是一套自动化(22:00 cron抓消息→LLM拆解→去重落库→08:00推送复盘,用户输入只有一句话);开发流程用/goal命令兜住——给一个客观可验证的终止条件("README不再出现NIM字样且grep返回空"),Claude自己跑到条件满足,不用每轮回"继续"。三层结构总结:CLAUDE.md定规范→Agent配置定角色→定时循环或/goal驱动执行。每次打开终端不是写代码,是审查它已经写好的东西——这才是效率的来源。
我的总结:AI编程工程化的三篇进阶——AI Agent军团:1+3+X框架(组织层)、本篇(工程层)、半天用Claude Code造一个外链提交插件(任务层),从战略到战术到单点全齐。