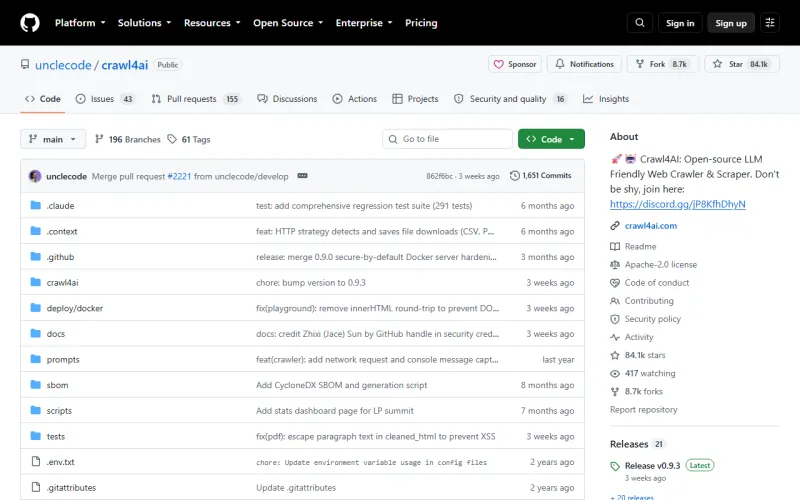
今天苏米要分享的是一个苏米关注很久的开源项目最新动态——Crawl4AI:专为 LLM 优化的开源爬虫与数据提取工具,GitHub 已经 17,000+ star,是当下最火的基础设施级开源项目之一。
它是什么
传统爬虫抓回来的是 HTML,喂给大模型前还要清洗;Crawl4AI 直接产出LLM 友好的格式(干净的 Markdown/结构化数据),内置无头浏览器、内容分块、自动去噪,还有浏览器自动化能力。一句话:爬虫到模型之间那条脏活累活的管道,它全包了。
为什么值得看
AI 应用的数据饥荒是长期的:任何 RAG、Agent、GEO 项目都需要持续的高质量网页数据输入,而反爬越来越严。Crawl4AI 卡在这个需求的主干道上,17k star 的速度说明开发者在用脚投票。
苏米觉得可抄的点
两层:一是直接用它——做 AI 产品的数据管道别再造轮子了;二是学它的定位——「为 LLM 优化」这个角度让它在几十个爬虫库里瞬间差异化。老品类 + 新场景(AI)= 新物种,这个公式在你的领域里找一找,可能就藏着一个 17k star 的位置。
开源仓库:GitHub 搜 unclecode/crawl4ai | 来源:ezindie 变现周刊第 157 期
声明:本站原创文章文字版权归本站所有,转载务必注明作者和出处;本站转载文章仅仅代表原作者观点,不代表本站立场,图文版权归原作者所有。如有侵权,请联系我们删除。