一个 WIRED 记者把手机绑在头上录自己洗碗叠衣服一周,赚了 21.55 美元——买主不是短视频平台,而是训练机器人的 AI 公司。这个叫 Kled 的平台已经有 50 万用户把照片、视频甚至报税文件卖给 AI,一个卡车司机靠行车记录仪月入 8000 美元。它揭示的变化比"数据换钱"深得多:AI 训练数据正在从"互联网里随便抓",变成一种需要被主动生产、授权和购买的商品。
一、Kled 是什么:把生活卖给 AI
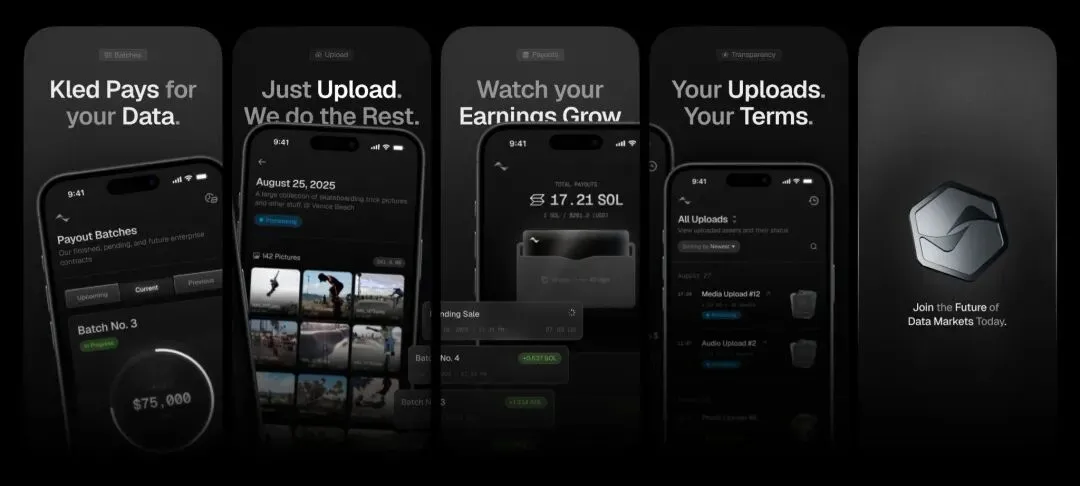
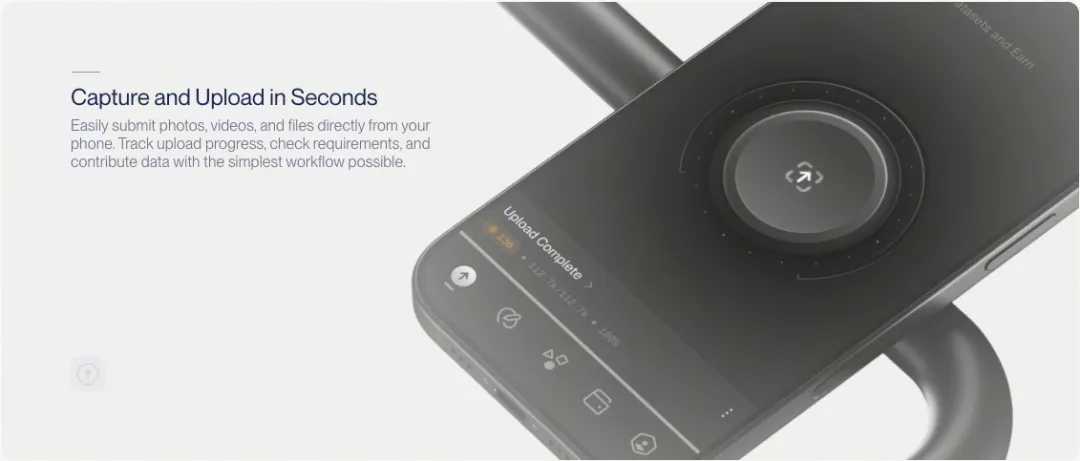
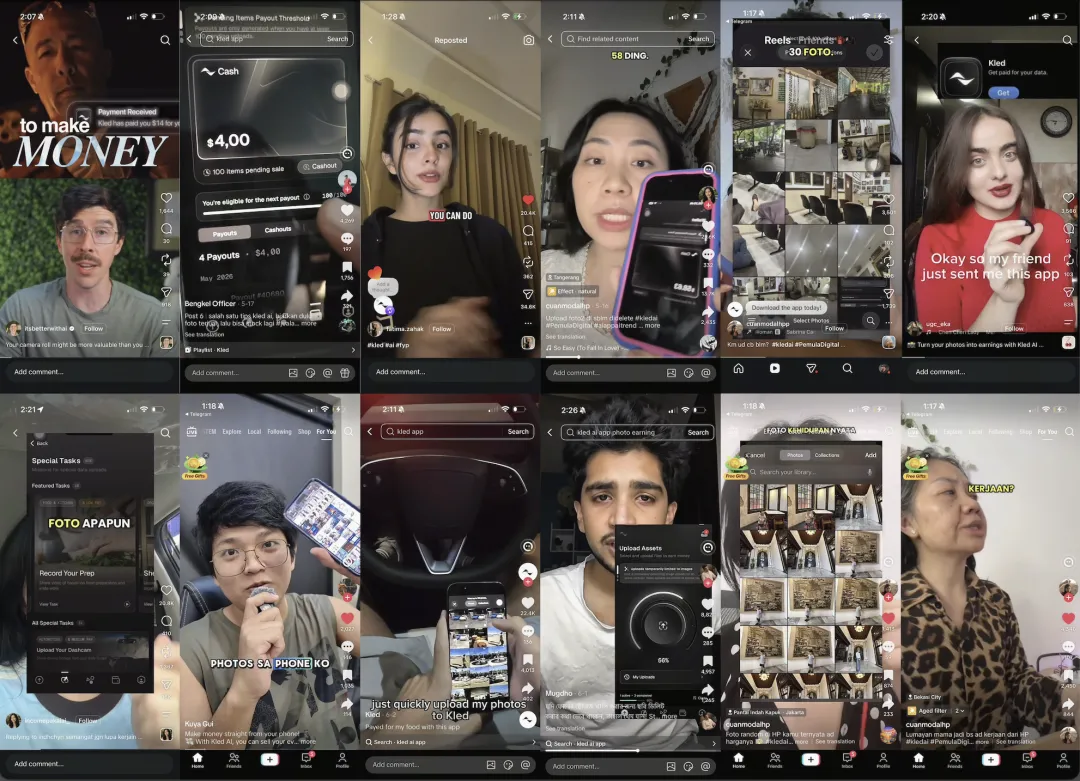
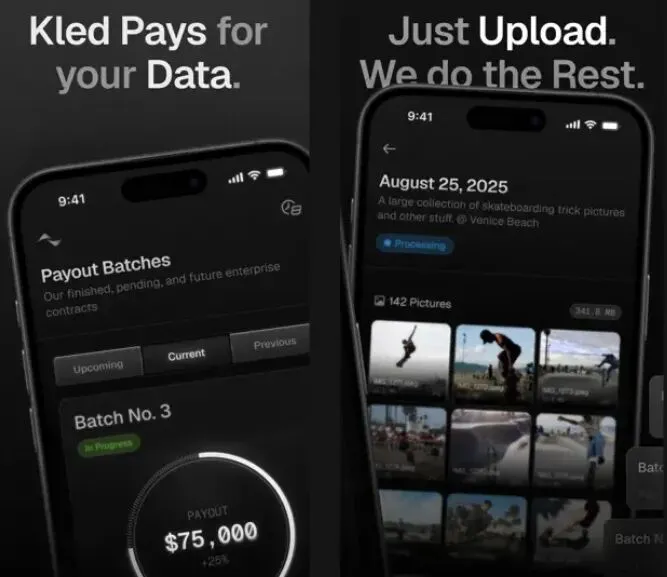
产品一句话就能解释:把自己的照片、视频、文档和生活数据上传,AI 公司买走这些数据并向你支付费用。严格来说不是把文件所有权一次性卖掉,而是把使用和训练权授权出去。用户可以直接上传手机相册里的照片视频文档,也可以完成企业发布的特定任务——Kled 曾公开列出美国市场的任务价:拍一段自己倒垃圾的视频 5 美元;上传 500 张自拍 1000 美元;上传一份报税文件 150 美元。不同任务价格差距很大,因为 AI 公司缺的数据完全不同。你可能会想到数据标注平台 Scale,但两者在产业链的不同位置:Scale AI、Mercor 这类是找人对已有数据做标注评价或完成专业任务;Kled 做得更靠前——它解决的是这些真实的人类数据从哪里来。AI 公司告诉 Kled"我需要人在厨房操作物品的视频、美国道路上的坑洞、卡车行驶的真实录像、大学生真实写的作业",Kled 再把需求拆成任务分发给几十万普通用户。所以一个 Kled 用户本质上不是数据标注员,更像分布在全球各地的人类传感器。
二、为什么机器人突然需要看你洗碗
训练 ChatGPT 和训练机器人缺的数据完全不一样。训练语言模型可以从互联网获得大量网页、书籍、论坛、代码;但想让机器人学会拿杯子、开抽屉、叠衣服、从冰箱拿牛奶——互联网其实没有那么多适合训练的数据。机器人需要知道的不是"什么叫洗碗",而是手从什么角度抓住盘子、海绵碰到盘子后怎么移动、洗完放哪里。这类数据叫第一视角数据:从人的视角记录一个人到底是怎么完成现实世界动作的——所以那位记者要把手机绑在头上,还要确保十根手指都出现在画面里:机器人要学的是他的动作,不是他的厨房。随着机器人、自动驾驶和世界模型的发展,这类需求正快速增加,业内有人预计未来几年领先企业可能从第三方购买数亿小时的第一视角视频。这也解释了为什么一个卡车司机可能比天天拍咖啡自拍的人值钱得多:他每天开几小时卡车,行车记录仪自然产生道路、车辆、交通标识、天气、施工、突发状况的数据——恰好是自动驾驶和视觉模型需要的。据 Kled 创始人提供的数据,平台收入最高的用户之一就是一名卡车司机,上传行车记录仪视频和道路坑洞数据,一个月最高赚约 8000 美元(极端案例;菲律宾、马来西亚等市场普通用户更接近每月 20-40 美元)。
三、50 万用户是怎么长起来的
创始人 Avi Patel 今年只有 22 岁:上大学两周就退学创业,最初做音乐授权项目没成功,后来把注意力转到另一个同样与"授权"有关的问题——AI 公司越来越缺有合法使用权的数据。Kled 最初验证的问题很简单:如果明确告诉普通人"你的数据会被拿去训练 AI,但我们给你钱",你愿不愿意上传?答案比很多人想象中积极。2025 年最初几个月还是网页产品,官方披露前五批支付给用户的金额分别是 5.2 万、6.4 万、7.5 万、15 万、35 万美元——三个月累计近 70 万美元。之后做成手机 App 增长明显加快:移动端上线约 30 天后达到约 20 万日活、每天处理 300 万-450 万份文件;到 7 月用户正式突破 50 万。资本也迅速跟进:今年 3 月完成 550 万美元种子轮(累计融资达 1000 万),6 月 The DATA Foundation 又投 300 万,累计已达 1400 万美元。
四、真正卖的不是照片,是整理好的训练数据
如果只是让 50 万人把相册倒进服务器,没有多大价值——AI 公司要的不是垃圾场,而是可以直接拿来训练的数据集。所以 Kled 中间做了一层重要工作:用户上传后系统检查重复、抄袭和 AI 生成内容,再自动分类、标注、添加元数据,最后把几十万用户的零散内容整理成第一视角操作数据、医疗影像、道路城市交通数据、学术内容、消费行为数据等结构化数据集——今年 3 月披露已整理出超过 1.2 万个结构化数据集。企业付钱买的是这些数据集。这也是生意比看起来复杂的地方:AI 公司现在买训练数据不只问"你有多少数据",还要问——这些数据是谁产生的?这个人有没有授权?有没有版权问题?是不是 AI 自己生成的?付钱记录在哪里?Kled 甚至专门给每份数据建立审计记录(内容哈希、授权记录、支付记录、时间戳),让买方能够验证来源。它真正建设的是两端:一边是几十万普通人的数据供应网络,另一边是让 AI 公司放心购买的数据授权体系。
五、卖数据和送外卖的本质区别
送完一单外卖,劳动就结束了;但一段数据一旦进入 AI 训练系统,生命周期可能非常长。看 Kled 2026 年 7 月 21 日更新的服务条款:用户仍保留上传内容的所有权,但同时授予 Kled 非常广泛的使用许可——涉及 AI 和机器学习模型开发、训练、测试和部署的部分,许可是全球范围、永久、不可撤销、可转让、可再许可,而且具有排他性。也就是说从商业逻辑上,这不是"发一张照片赚 5 美元",而是更接近:用 5 美元换取这份数据未来长期用于 AI 训练的权利。对一张道路照片可能无所谓,但当平台开始收自拍、家庭录像、学习资料、财务数据甚至报税文件,问题就完全不同了。Kled 表示会做匿名化、敏感信息处理和授权审计,但"用户主动同意"不意味着隐私风险自动消失——这会是这类产品未来最大的商业挑战之一:AI 公司越愿意为稀缺私密的数据付高价,普通人越愿意上传;但数据越稀缺越私密,平台要承担的信任、合规和安全责任也越高。

六、"数据"可能真的会成为一种工作
过去互联网的逻辑是:你免费用 Facebook、Instagram、Google,平台免费获得你的行为数据再拿去赚钱,用户几乎不参与分配。Kled 想把这个关系翻过来:既然 AI 公司最后需要我的数据,为什么不能直接付钱给我?这件事能做到多大现在还难判断——50 万用户、每天数百万上传和 1400 万融资,大部分数据来自公司自己披露;普通用户实际能赚多少也取决于国家、职业和有没有企业刚好需要你的数据。但它已经证明了一件事:AI 训练数据正在变成需要被主动生产、授权和购买的商品。而一旦数据被明确标价,就会出现一整套新产业链——有人负责产生数据,有人负责验证、清洗、授权,有人把 AI 公司的需求拆成普通人可以完成的任务。
我的总结:Kled 是"数据供给侧的平台化"样本,需求端的故事站内已有对照——靠人类动作数据融资 6000 万的机器人公司讲为什么第一视角数据值钱,Arena 的 8200 万张投票讲另一种"用户行为变资产"的路径。供给和需求两端看完,这个赛道的机会地图就清楚了。