机器人行业最热闹的是人形机器人和基础模型,但有一家公司反着来:自己不造机器人,专拍人怎么切洋葱、洗碗、做咖啡——靠"人类动作数据"在 2026 年融到 6000 万美元,并声称基于已签合同年化收入可达 1 亿美元。Mecka AI 做的事情很像"机器人时代的 Scale AI":Scale 当年帮大模型处理图像文本标注,Mecka 做机器人训练数据的采集、清洗、标注、评估和交付。
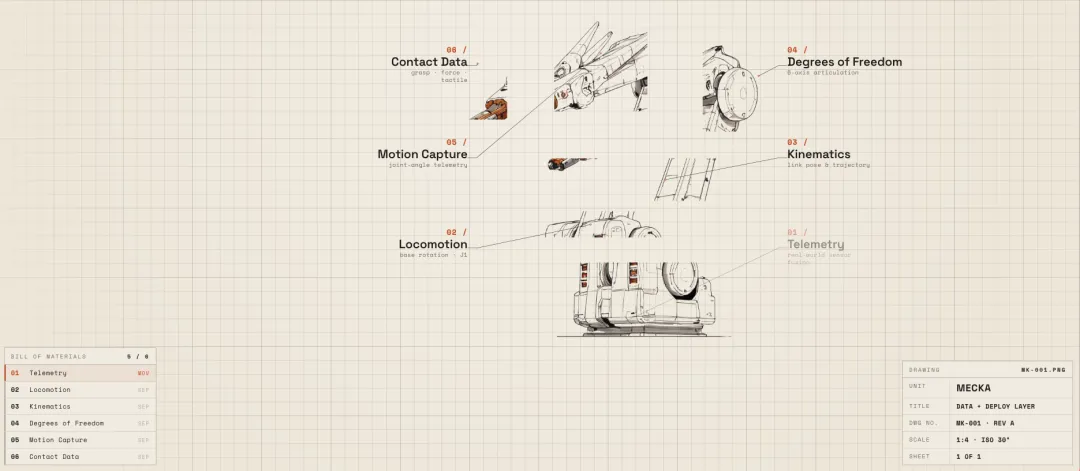
换成直白的话,Mecka 主要做三件事:采集真实世界里的人类动作数据;把原始视频、传感器数据、动作信息处理成机器人模型能用的数据集;帮机器人团队做模型评估和真实场景部署前的准备。它自己不造机器人,而是作为生态里的集成者,连接硬件、模型和商业场景,负责中间的数据与集成层。
为什么机器人公司需要这类数据
过去训练机器人常见三种方式,各有硬伤。一种是遥操作——人远程操控机器人完成任务并记录数据,好处是数据来自真实机器人,但慢、贵、难规模化,覆盖上千种任务就堆不动了。第二种是仿真——便宜快可重复,但真实世界太复杂:厨房的反光、桌面的遮挡、布料的褶皱、手和物体的接触、食材切开后的形态变化,很多细节模拟不出来,落到真实环境总有差距。第三种是互联网视频——量大,但大多不是为机器人训练准备的,缺少统一视角、动作轨迹、任务标签和物体信息,很难转成可执行动作。
Mecka 押的是另一条路:第一视角的人类动作数据——让人用 iPhone、身体传感器和定制硬件,从自己的视角记录真实任务。这种数据比遥操作容易规模化(人类本来就在真实世界里做这些事),比普通互联网视频更有结构(采集可以围绕特定任务设计),比纯仿真更接近现实(来自真实厨房、实验室、工作台和工厂)。它的核心判断是:机器人要学习现实世界,最好的老师可能不是机器人,而是人。
不是"找人拍视频"这么简单
如果只理解成"拍一堆人类做家务的视频",会低估 Mecka。它做的是一套数据工厂,四步走。
第一步定义任务:客户想让机器人学会咖啡制作、实验室操作、仓储分拣或某个具体工序,Mecka 先把任务拆清楚——场景是什么、动作是什么、需要哪些视角和物体、需要多少样本、怎么标注、如何判断成功失败。机器人数据不是拍得越多越好,任务定义不清楚,采集再多也只是噪音。
第二步采集数据:除了 iPhone、身体传感器和定制硬件,它还上线了一个 iOS App 做第一视角录制——手进入画面自动开始录制、快速上传内部基础设施、按实验和目标管理任务、减少研究团队每天采集的操作成本。这说明它没停留在"组织人拍视频"的层面,而是在做采集工具:采集流程越标准,后面的清洗、标注、训练和复用才越容易。
第三步处理原始数据:原始视频不等于训练数据。机器人模型需要知道任务是什么、手在哪里、物体是什么、动作顺序、关键接触点、哪些成功哪些失败、环境有什么变化——所以还需要标注、上下文、质量检查、动作理解和评估流程。Mecka 真正卖的是:把真实世界的人类活动,处理成机器人模型能学习、能检索、能评估的数据。
第四步交付和评估:客户包括机器人实验室、前沿模型团队和正在部署具身系统的企业,合作方式从数据集访问、定制任务采集、模型评估到完整数据项目——它想做长期基础设施,而不是一次性数据外包。
EgoVerse 是它的样板间
理解 Mecka 必须看 EgoVerse——一个围绕第一视角人类数据建立的机器人学习生态,由学术实验室和产业伙伴共同参与。当前版本包含:1362 小时人类演示、约 8 万个片段、1965 个任务、240 个场景、2087 名演示者。任务非常具体:做面团环、整理毛绒玩具、洗碗、清理冰箱零件、组装架子、切姜、熨衣服、装洗碗机……
这些日常任务恰好解释了 Mecka 的价值:对人来说装洗碗机几乎不用思考——判断盘子大小、调整角度、避开旁边的碗、插到合适位置;但对机器人来说,这里有视觉理解、空间判断、手眼协调、接触控制和任务规划。文字说明远远不够,它需要看大量真实操作。对 Mecka 来说 EgoVerse 像一个公开样板间:证明自己不是只会讲"机器人需要数据"的故事,而是真的在搭数据采集、处理、浏览和研究协作的基础设施。

四个创始人:不是传统机器人团队
四位创始人 Josh Gao、Mogen Cheng、Jason Chong 和 Duy Nguyen 都不是从顶级机器人实验室出来的。CEO 和 CPO 此前一起做过餐饮支付软件创业;CTO 是 Utopia Labs(加密支付工具公司,被 Coinbase 收购)的联合创始人兼 CTO,背景偏工程和数据系统;COO 的经历更不典型——很早进入球鞋转售市场,靠倒卖球鞋赚到数百万美元。餐饮支付 CEO + 餐饮科技 CPO + 卖过加密公司的 CTO + 做过球鞋转售的 COO——显然不是传统机器人创业团队,但也正是它有意思的地方:数据运营和交付能力,比机器人学术背景更贴合这门生意的本质。

商业模式的四层与三个风险
商业模式可以拆四层:定制数据集(按客户需求组织采集、处理、标注、交付);数据平台访问(EgoVerse 这类生态扩大后形成可订阅可检索的数据平台,比一次性项目更有平台价值);模型评估(不是跑 benchmark,而是真实环境真实物体真实流程的评估体系);部署支持(它反复强调自己是 data and deployment layer,参与机器人进入商业场景前后的集成,更像部署服务商而不只是数据供应商)。
风险同样清晰。第一,人类数据能否迁移到机器人还需持续验证:人有五指和触觉,机器人可能是两指夹爪或机械臂,动作不能直接复制——关键不是采集更多视频,而是把人类动作处理成机器人能学习的表示,EgoVerse 也明确提到有效扩展取决于人类数据和机器人学习目标之间的对齐。第二,大客户可能自建:核心机器人公司会把数据看成护城河,Mecka 必须证明自己是客户自建也很难快速复制的基础设施。第三,数据合规:第一视角数据天然敏感,家庭、实验室、工厂可能拍到人、空间布局、商业机密,授权、匿名化、跨境传输、数据归属都不是小问题。

我的总结:再高大上的 AI 背后,也离不开数据采集、处理、评估这些苦生意——这是 Mecka 给我的最大提醒。对普通创业者,它的可借鉴点不是去做机器人数据(那是重资源生意),而是"在热闹赛道的底层找脏活"这个选品思路:所有人都盯着模型和应用时,数据、评估、集成这些没人愿意干的环节反而成了基础设施。同类思路的落地版可以看独立开发者变现指南里"工具型资产"的章节。